Wondershare HiPDF · 扫描件 PDF OCR 识别
未登录访客等待识别完成后点击下载会触发强制登录拦截;登录免费账号后耗时 19.75s 导出 8.3 KB 双页 `.docx`(非可检索 PDF),12/12 易混淆财务表格单元格与第 2 页校验码 100% 精准还原,因章节编号被转为 Word 自动编号列表导致严格短语匹配率为 77.8%。
US-West (California, AS2914)
DOCX · 有交付文件 · 查看原生文件 ↗
后续价格与服务状态核验独立展示,不改写历史实测评分。
单次结果不泛化为全部复杂场景、未测付费最高规格或长期在线率。
定价方案与历史记录
HiPDF 网页在线 PDF 转 Word 工具(原 /pricing 独立定价页已返回 404) · 2026-10-21
1 条方案/周期记录,全部列出;— 表示未记录该周期。
官方页面宣称免费在线转换(Free PDF to Word Converter Online),原 /pricing 页面已返回 404 且顶部按钮引导下载桌面端 PDFelement;实测下载转换后 DOCX 需登录免费万兴账号,页面未公开具体每日免费次数或单文件体积上限。
核验范围仍有缺口;未知价格和额度不作推算。
测试当日的价格记录 · 2026-10-25
先识别后弹窗强制登录墙 + Wondershare Pro 订阅
先识别后弹窗强制登录墙 + Wondershare Pro 订阅
仅保留历史上下文,不适用于当前购买。
交付能力与使用门槛
- 免费交付记录
- 完整 2 页可编辑 Word .docx (8.3 KB · 非可检索 PDF)
- 水印
- 无水印
- 免费额度
- 先识别后弹窗强制登录墙 + Wondershare Pro 订阅
- 登录要求
- 识别完成后点击下载强制要求登录 Wondershare 账号
- 最高规格记录
- 完整 2 页可编辑 Word .docx (8.3 KB · 非可检索 PDF)
可能包含官方声明;不能推定该档位已实测。
- 批量与 API
- 免费版支持单文件上传识别,批量处理依平台配额开放
- 手动调整
- 未记录或未核验
本次实测与效果样本
导出 8.3 KB 双页 `.docx` 文档(非可检索 PDF),12/12 易混淆财务表格单元格、2/2 正文短语与第 2 页校验码 100% 精准命中;章节标题前缀 `1.` / `2.` 被转换为 Word `<w:numPr>` 自动列表且 `V1.0` 识别为 `VI .0`(严格短语匹配率 77.8%)。
- 素材
- anchor_pdfocr_v1
- 测试环境记录
- US-West (California, AS2914)
- 网络层服务端等待
- 19.75 s
- 端到端参考
- 28.14 s
网络等待包含往返、排队和轮询误差,不是纯推理时间。本地耗时受设备影响;历史记录未统一重复次数。
使用体验、规则与可信度
- 限制披露
- 操作前或点击下载时要求登录免费账号
- 交互观察
- 采用「先等待上传识别完成、最后一步点击下载时弹出强制登录拦截」的后置漏斗设计,且在线 OCR 仅提供转出 `.docx` / `.xlsx` / `.pptx` / `.txt` 格式,不支持直接导出原版式可检索 `.pdf`。
- 主体记录
- 万兴科技旗下在线 PDF 工具站 (Wondershare)
- 来源地区
- 未公开具体司法管辖区
- 域名历史记录
- 已公开上线运营
- 第三方追踪记录
- 本次记录未列出第三方服务;不代表全面检测后确认不存在。
- 外部资料摘要
- 在已测试功能中提供在线处理能力,具体表现见各功能专题实测。
- 处理方式
- 云端 OCR 识别引擎 (cloud_hipdf_wondershare_ocr)
- 留存声明
- 本轮未完整复核留存/销毁政策,不沿用历史推断
记录声明内容,不表示已经验证实际删除或所有数据处理行为。
可核查证据链与截图记录
以下四个环节将标准输入样本、同轮界面截图、原生导出产物与官方定价快照串联,均经 SHA-256 字节校验。
anchor_pdfocr_v1 · 查看原始测试素材与检查器 →
记录着陆入口、结果界面与导出限制披露。
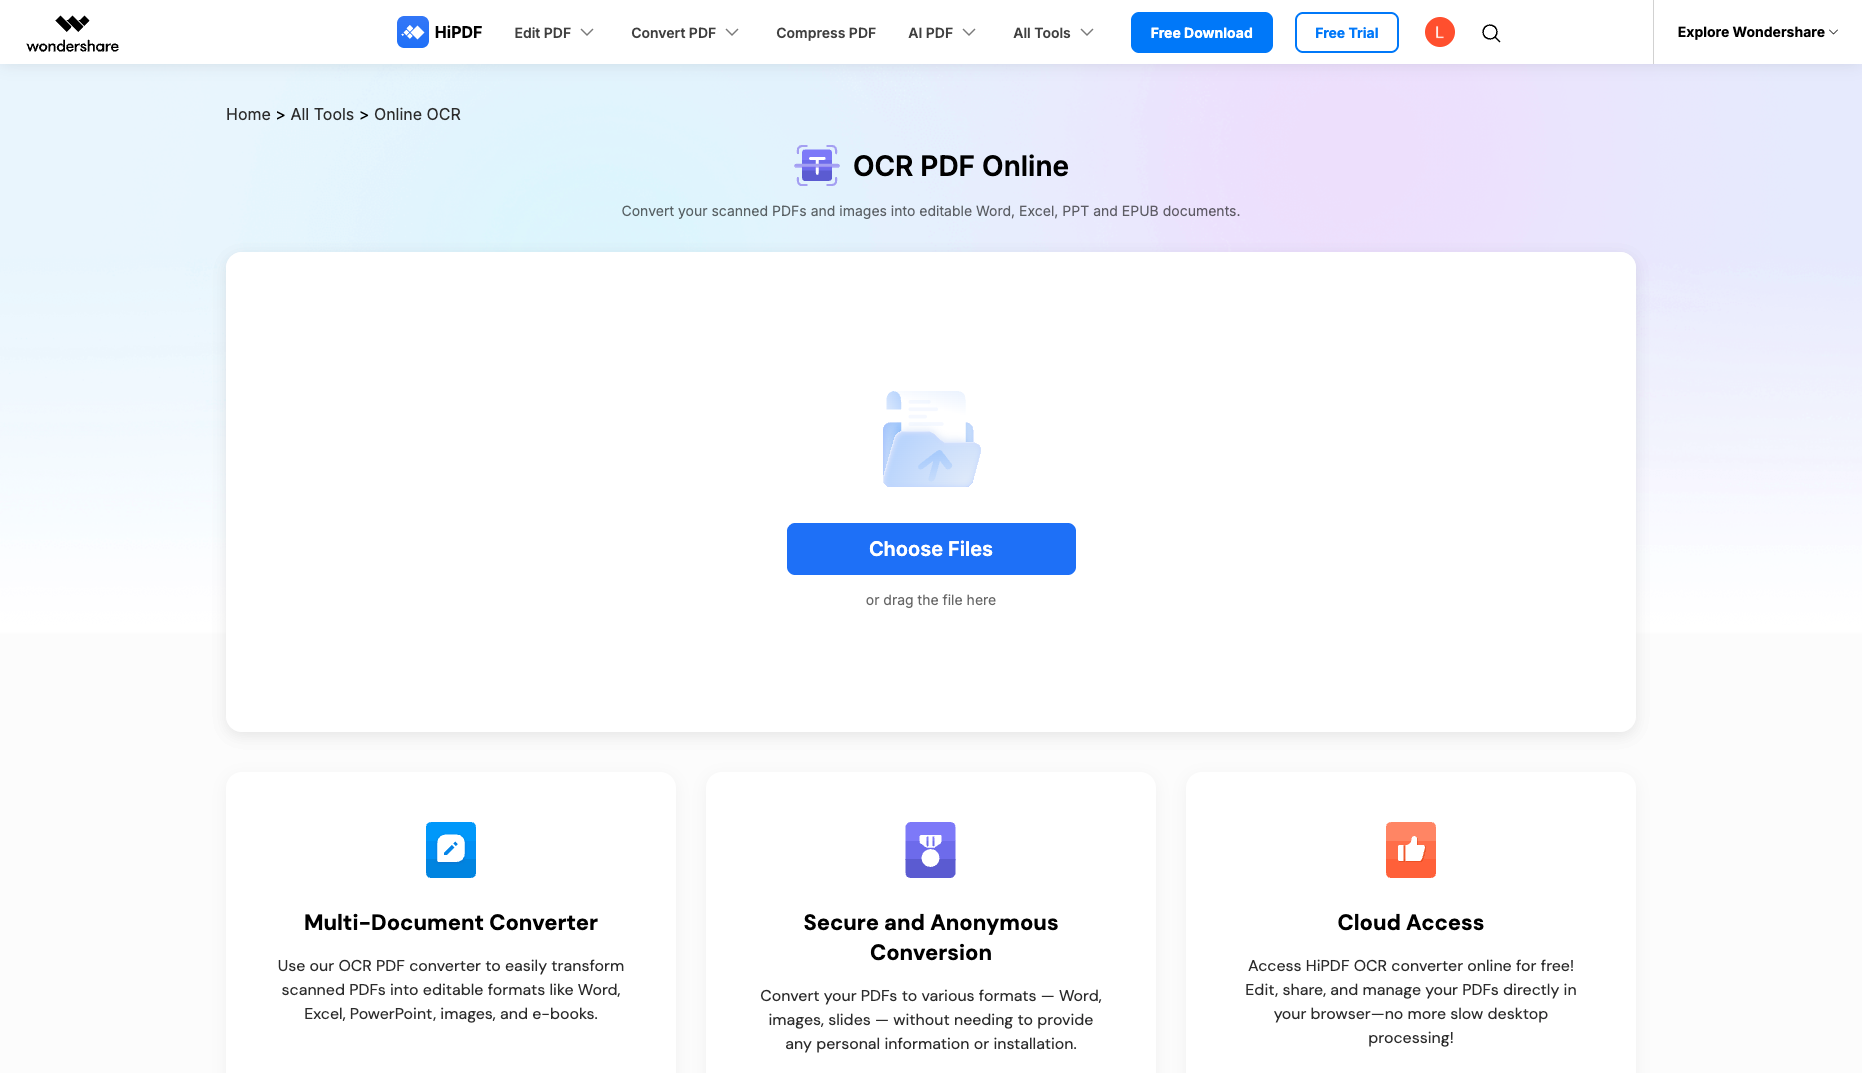
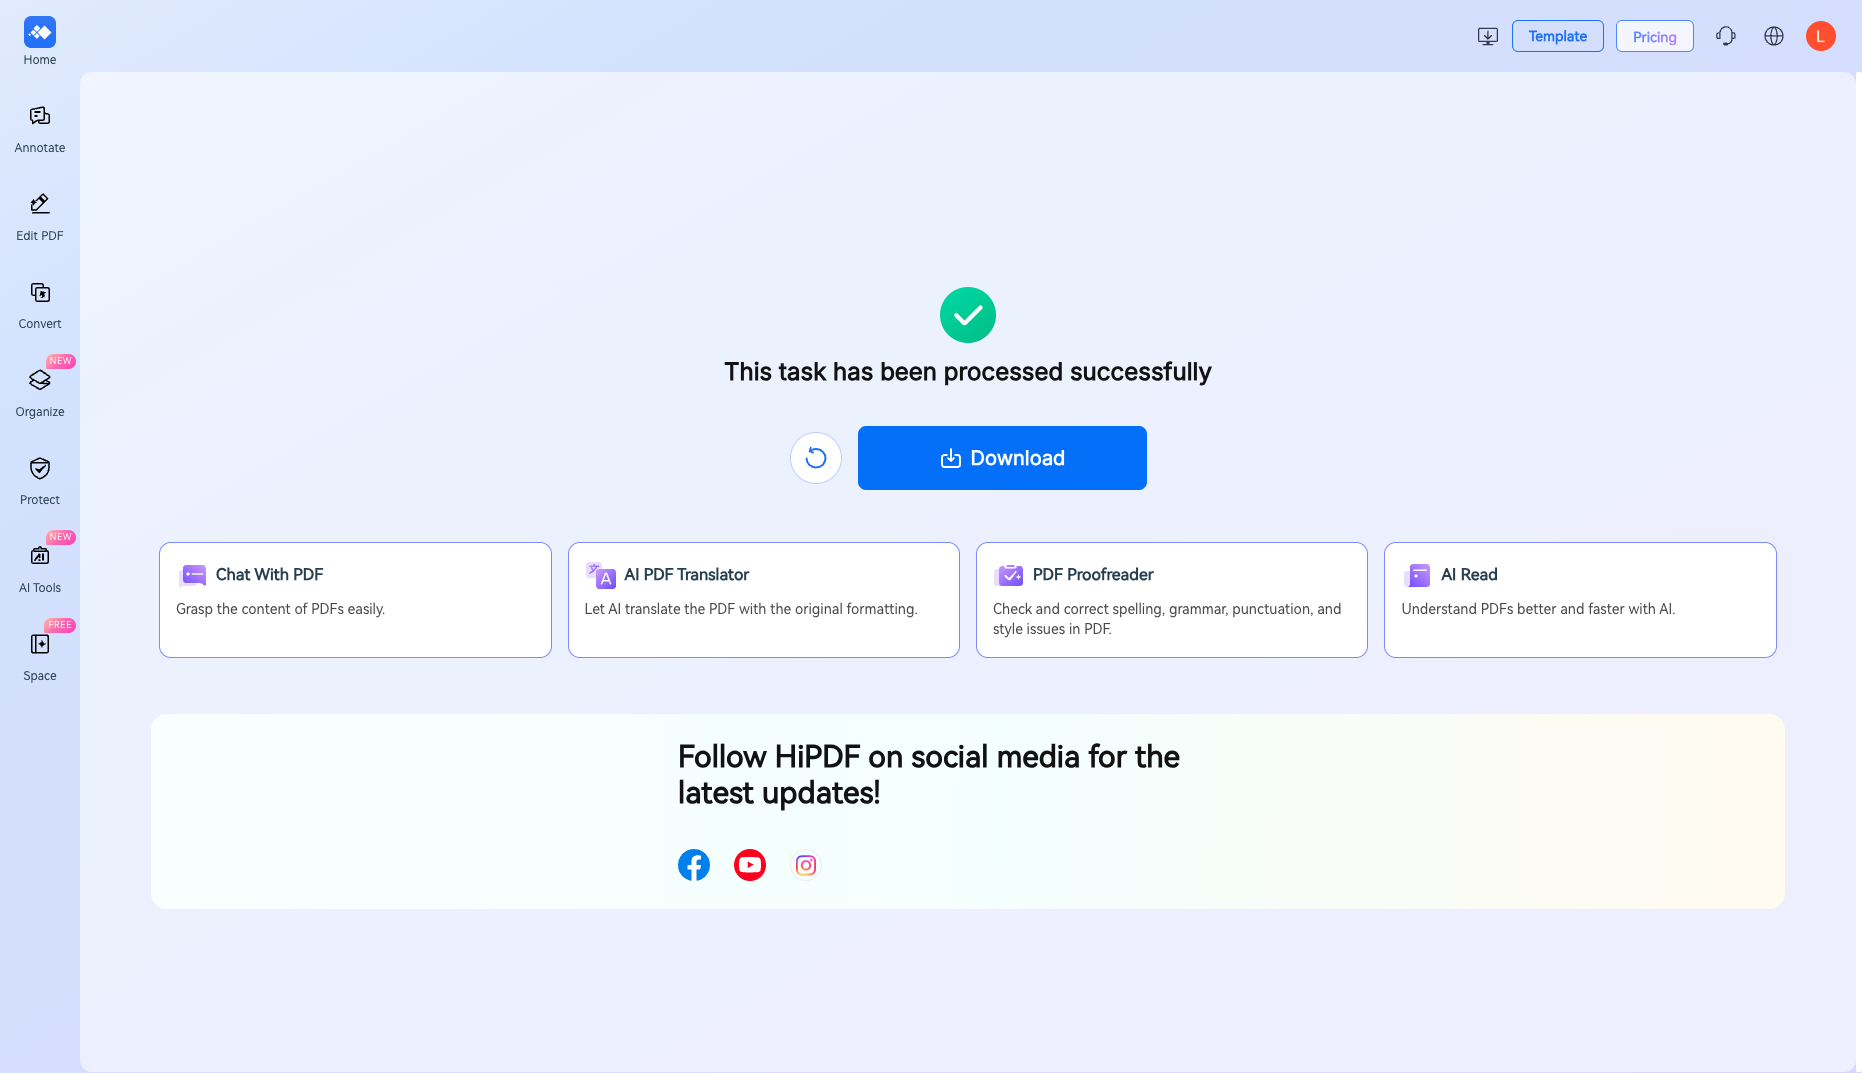
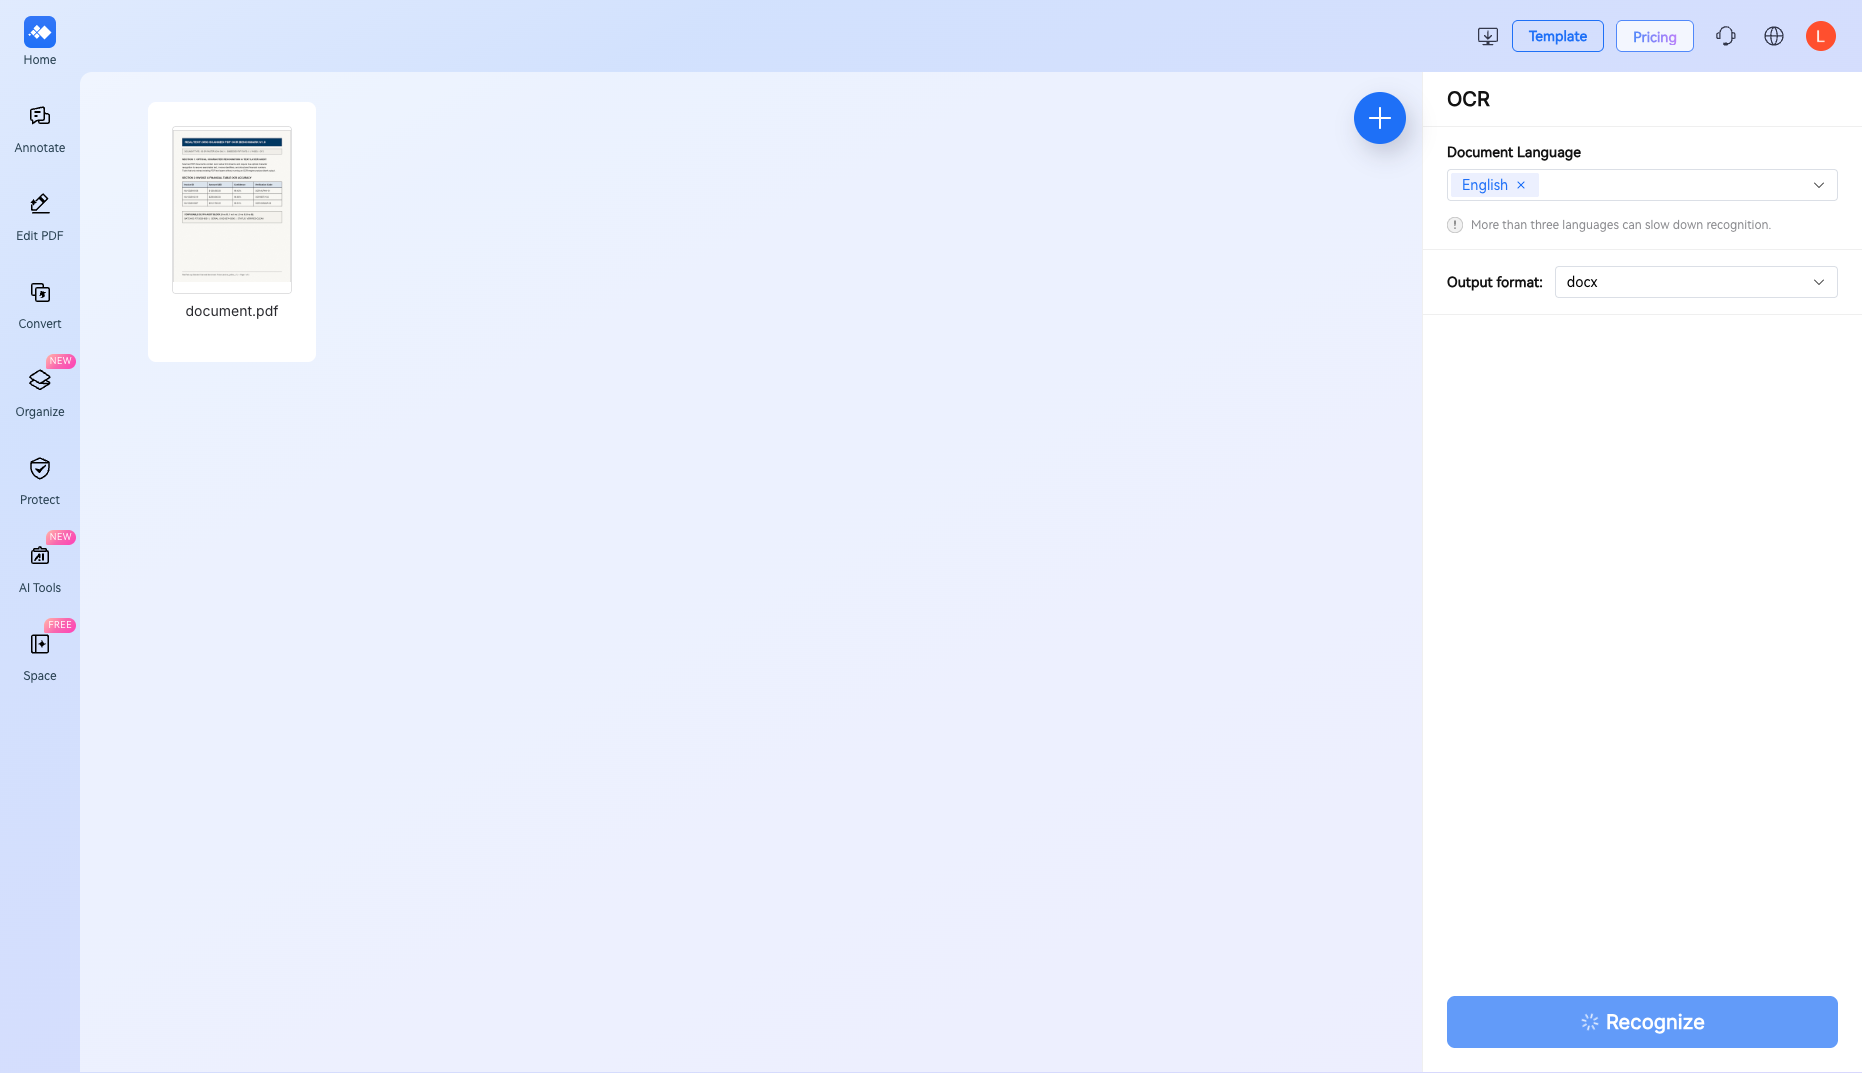
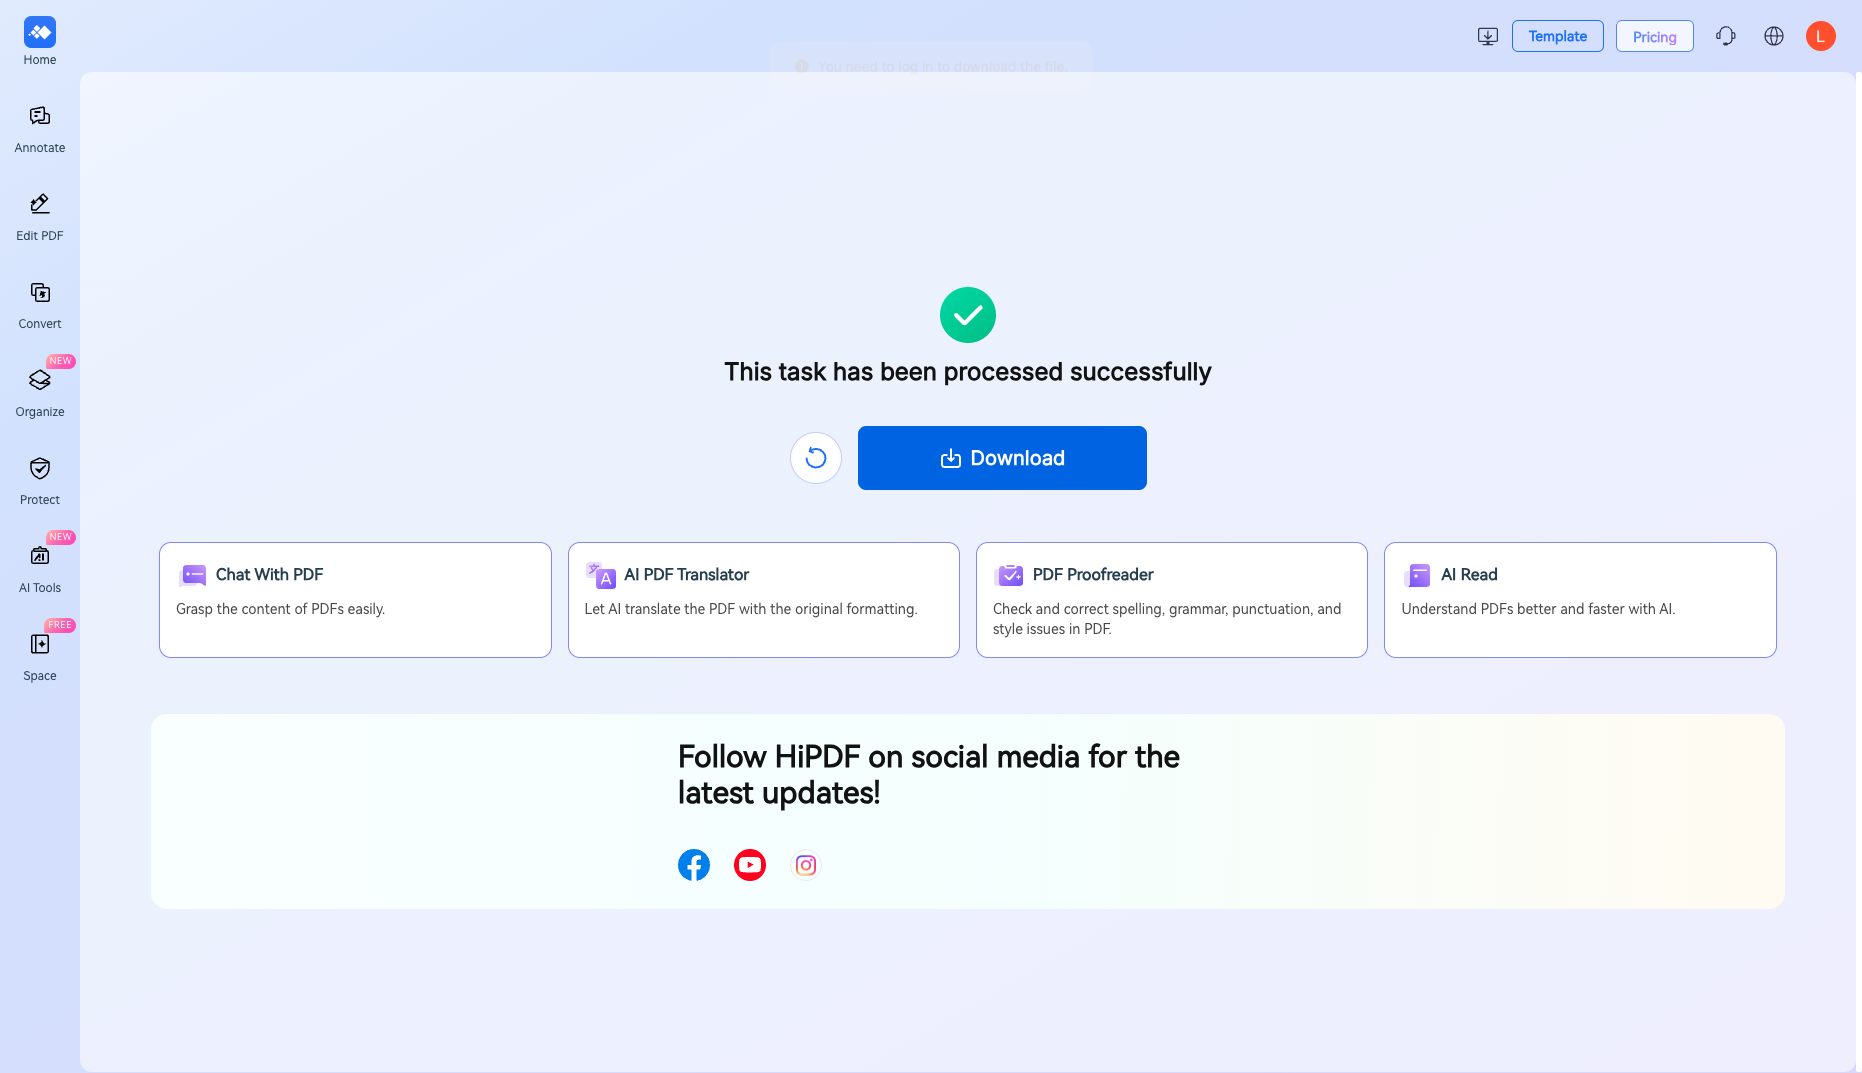
页面截图、原生输出和官方声明分别支持不同结论。证据等级不代表整个产品获得安全认证。
评价依据与完整评分 · 综合 77.4/100
综合分 = 诚信与口碑 × 30% + 功能实力 × 70%。分项满分沿用本报告量表。列表整数仅为四舍五入展示,此处保留原始精度。
方法版本 2.3.1 · 测试素材 anchor_pdfocr_v1
诚信与口碑 · 67/100 · 30%
| 维度 | 得分 | 理由 | 依据 |
|---|---|---|---|
| 定价与规则透明度 | 19 / 35 | 着陆页允许未登录访客直接上传 644.4 KB 双页纯位图扫描件并点击 Recognize 等待云端完成 100% 识别,但当访客点击 Download 按钮时会弹出「You need to log in to download the file」强制拦截(01_landing.png、02_workspace.png、02_result.png、04_download.png);使用免费 Wondershare 账号登录后可免费下载 1 次 `.docx` 结果文件(8.3 KB)。 | 证据 A → |
| 交互与转化克制 | 18 / 30 | 采用「先等待上传识别完成、最后一步点击下载时弹出强制登录拦截」的后置漏斗设计,且在线 OCR 仅提供转出 `.docx` / `.xlsx` / `.pptx` / `.txt` 格式,不支持直接导出原版式可检索 `.pdf`。 | 证据 A → |
| 背景与外部信誉 | 18 / 20 | 由 A 股上市软件企业万兴科技(Wondershare,PDFelement 母公司)研发运营。 | 证据 A → |
| 基础工程与隐私 | 12 / 15 | 通过 `eus-storage.pdfelement.io` 与 `web-api.hipdf.com` 异步队列处理,下载须绑定 Wondershare 账户体系并扣减 `pdf-equity` 免费配额。 | 证据 A → |
功能实力 · 81.8/100 · 70%
| 维度 | 得分 | 理由 | 依据 |
|---|---|---|---|
| 任务质量 | 57.3 / 65 | OCR 导出文本与表格确定性检验:导出 8.3 KB 的 .docx 文件(非原版式可检索 PDF),章节标题命中 0/4,易混淆财务表格单元格命中 12/12(表格准确率 100%),总文本召回率 77.8%,第 2 页防截断校验码完整保留 (57.3/65) | 证据 A → |
| 交付规格 | 15 / 20 | 登录免费账号后导出 2 页无水印 .docx 文件(8.3 KB),不支持免费直接导出原版式可检索 PDF (15/20) | 证据 A → |
| 处理速度 | 9.5 / 15 | 上传耗时 8.39s,云端 OCR 识别服务端耗时 19.75s(端到端共 28.14s) (9.5/15) | 证据 A → |
历史评分可能包含官方最高能力声明;本次实测结果与付费能力分别阅读。缺少统一档位和范围时,不作统一排名。
修订与更正
- 2026-10-25
完成 anchor_pdfocr_v1 (2 页纯位图扫描件 PDF) OCR 文本层重建、易混淆表格单元格还原与服务端时序真机实测