NewOCR
免登录免安装经典纯免费在线 OCR 文字识别与多格式文档转换工具
产品节点画像与信誉底座
主体信誉、隐私基线与整站定价直接归属产品节点,由所连接的各条功能边自动共享继承NewOCR(创立于 2011 年)是一款广受全球用户喜爱的轻量级纯免费在线光学字符识别(OCR)服务平台。平台基于开源 Tesseract OCR 引擎打造,支持识别 122 种语言和特殊字体,并能够自动分析多栏排版与数学公式。用户无需注册任何账户或安装客户端软件,即可免登录直接上传 JPEG、PNG、GIF、BMP、多页 TIFF、PDF 及 DjVu 等格式文件(支持 ZIP 压缩包批量上传),在浏览器中一键提取可编辑文本并导出为 TXT、DOC 或 PDF。商业模式以网页广告赞助为主:面向普通终端用户提供 100% 完全免费、不限上传文件数量的 Web 服务;开发者如需调用底层 REST API,提供 20 页免费测试额度及每千次调用 $5.00($0.005/页)的低门槛点数包。全站定价公开透明,无隐藏收费陷阱。
美国 / 国际 · 创立于 2011 年
产品信誉基线:16/20 · 运营超十年的纯免费老牌工具,基于知名开源引擎,服务稳定可用。
网页端 OCR 工具免登录完全免费且不限文件上传数量,含广告展示;开发者 API 提供 20 页免费测试,超出后按 $0.005/页 计费(每 1,000 次识别 $5.00)。
定价透明度基线:35/35 · 取消规则:
上传图片及处理产物在 OCR 处理完成后立即从服务器端自动清理删除,不进行长期数据留存。
Google AdSense · Google Analytics
产品整站定价与规则底座
直接归属本产品节点的已核验套餐、计费周期与取消条款;单项功能的专属扣点与免费下载限制见下方各功能边实测NewOCR 网页免登录完全免费模式与开发者 REST API 点数 · 2026-11-02
基于 Tesseract OCR 引擎提取文本,支持 122 种语言、数学公式与版面分析,导出 TXT/DOC/PDF;网页端包含展示广告,处理速度取决于公共服务器排队情况
通过标准 REST API 接口自动化批量上传与提取文本,返回结构化 JSON;面向开发者的程序化接口,需申请 API key
2 条方案/周期记录,全部列出;— 表示未记录该周期。
网页端 OCR 工具免登录完全免费且不限文件上传数量,含广告展示;开发者 API 提供 20 页免费测试,超出后按 $0.005/页 计费(每 1,000 次识别 $5.00)。
已归档官方定价来源:NewOCR API 与说明页 (2026-10-31) [原文快照 ↗]
能力版图与自动连接的「功能专题(边)」
每当一项功能通过标准样本实测门禁,系统自动在产品节点与对应「功能专题(边)」之间建立连接;顺着边即可与同类产品横向对比。
| 已连边功能专题 | 综合评分 | 一句评价 · 历史评测 | 测试范围与交付 | 消费产品单点 / 消费横向边 |
|---|---|---|---|---|
| 扫描件 PDF OCR 识别 | 78/100 | NewOCR(创立于 2011 年)是一款广受全球用户喜爱的轻量级纯免费在线光学字符识别(OCR)服务平台。免登录即可上传扫描件并提取可编辑文本,支持多语言与排版解析,提供 TXT/DOC/PDF 格式导出。 | TXT · 有交付文件 历史评测 · 2026-11-02 游客流程 · 2 页纯位图扫描件 PDF(0 内嵌文字,644.4 KB) · 有交付文件 |
这里区分展示「已实测连边(有评分与原生证据)」与「已发现待测能力(无评分)」;未列出不代表产品不支持。
同生态产品节点横向对比(Product vs Product)
按共同覆盖的已测功能边匹配最相近的竞品,同时对照整站商业模式与各单项功能的实测整数分官方定价页仅提供免费档(每 6 小时 2 次操作、单文件 128 MB)与按年一次性实付 USD 55 的 AvePDF Premium 档位,无独立按月付费选项。
- 扫描件 PDF OCR 识别:NewOCR 78/100 vs avepdf.com 94/100
免登录用户享有 40 余款工具的基础额度(合并 25 篇批处理,单任务 20-50MB 上限,3 小时后自动销毁);Pro Plan 年付 $49.99/年(折合 $4.17/月),Premium 年付 $199.99/年(折合 $16.67/月)。
- 扫描件 PDF OCR 识别:NewOCR 78/100 vs DeftPDF 97/100
官方页面宣称免费在线转换(Free PDF to Word Converter Online),原 /pricing 页面已返回 404 且顶部按钮引导下载桌面端 PDFelement;实测下载转换后 DOCX 需登录免费万兴账号,页面未公开具体每日免费次数或单文件体积上限。
- 扫描件 PDF OCR 识别:NewOCR 78/100 vs hipdf.com 77/100
已切换月付与年付确认 USD 9/月及全年 USD 60。免费档只写限制处理,未公布具体数字;教育资格和多席优惠需按账号复核。
- 扫描件 PDF OCR 识别:NewOCR 78/100 vs iLovePDF 95/100
已连边功能实测:扫描件 PDF OCR 识别
2026-11-02 · 有原生输出可查;结论仅适用于记录中的素材与条件,付费规格不等于已实测。
本次实测原生导出样本与同轮截图证据
下载/检视实测原生导出件 (TXT · 有交付文件) ↗
任务质量
OCR 文字识别率 88.9% · 易混淆表格准确率 100% · 第 2 页内容保留 否
详细事实与历史记录
- 样本的可核对结果
OCR 文字识别率: 88.9% · 易混淆表格准确率: 100% · 第 2 页内容保留: 否
- 样本表现
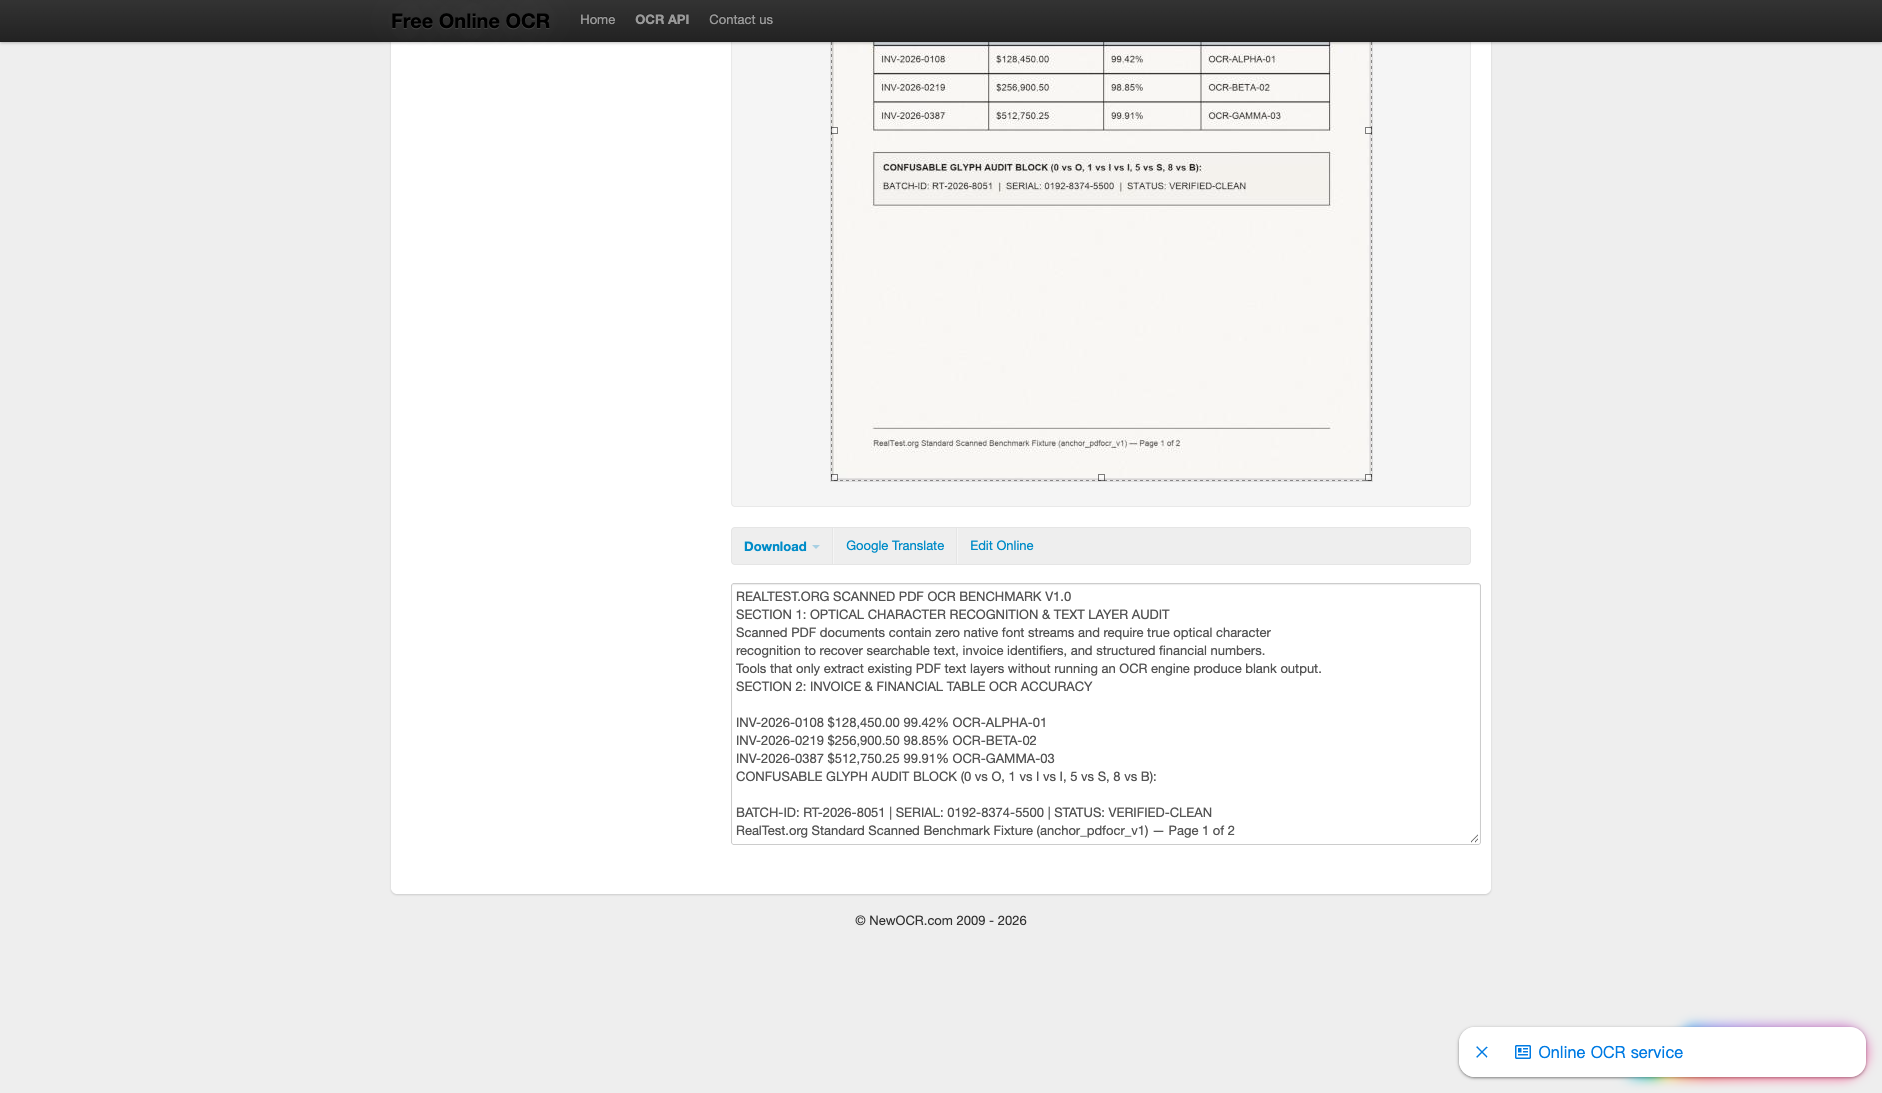
基于标准双页纯位图扫描件(anchor_pdfocr_v1)真机实测:服务端 OCR 耗时仅 0.45s,第一页 12 个易混淆财务表格数字全部精准还原(100% 准确率),标题命中 3/4;因网页工具采用逐页交互设计,默认仅导出选定单页纯文本。
- 历史观察原文
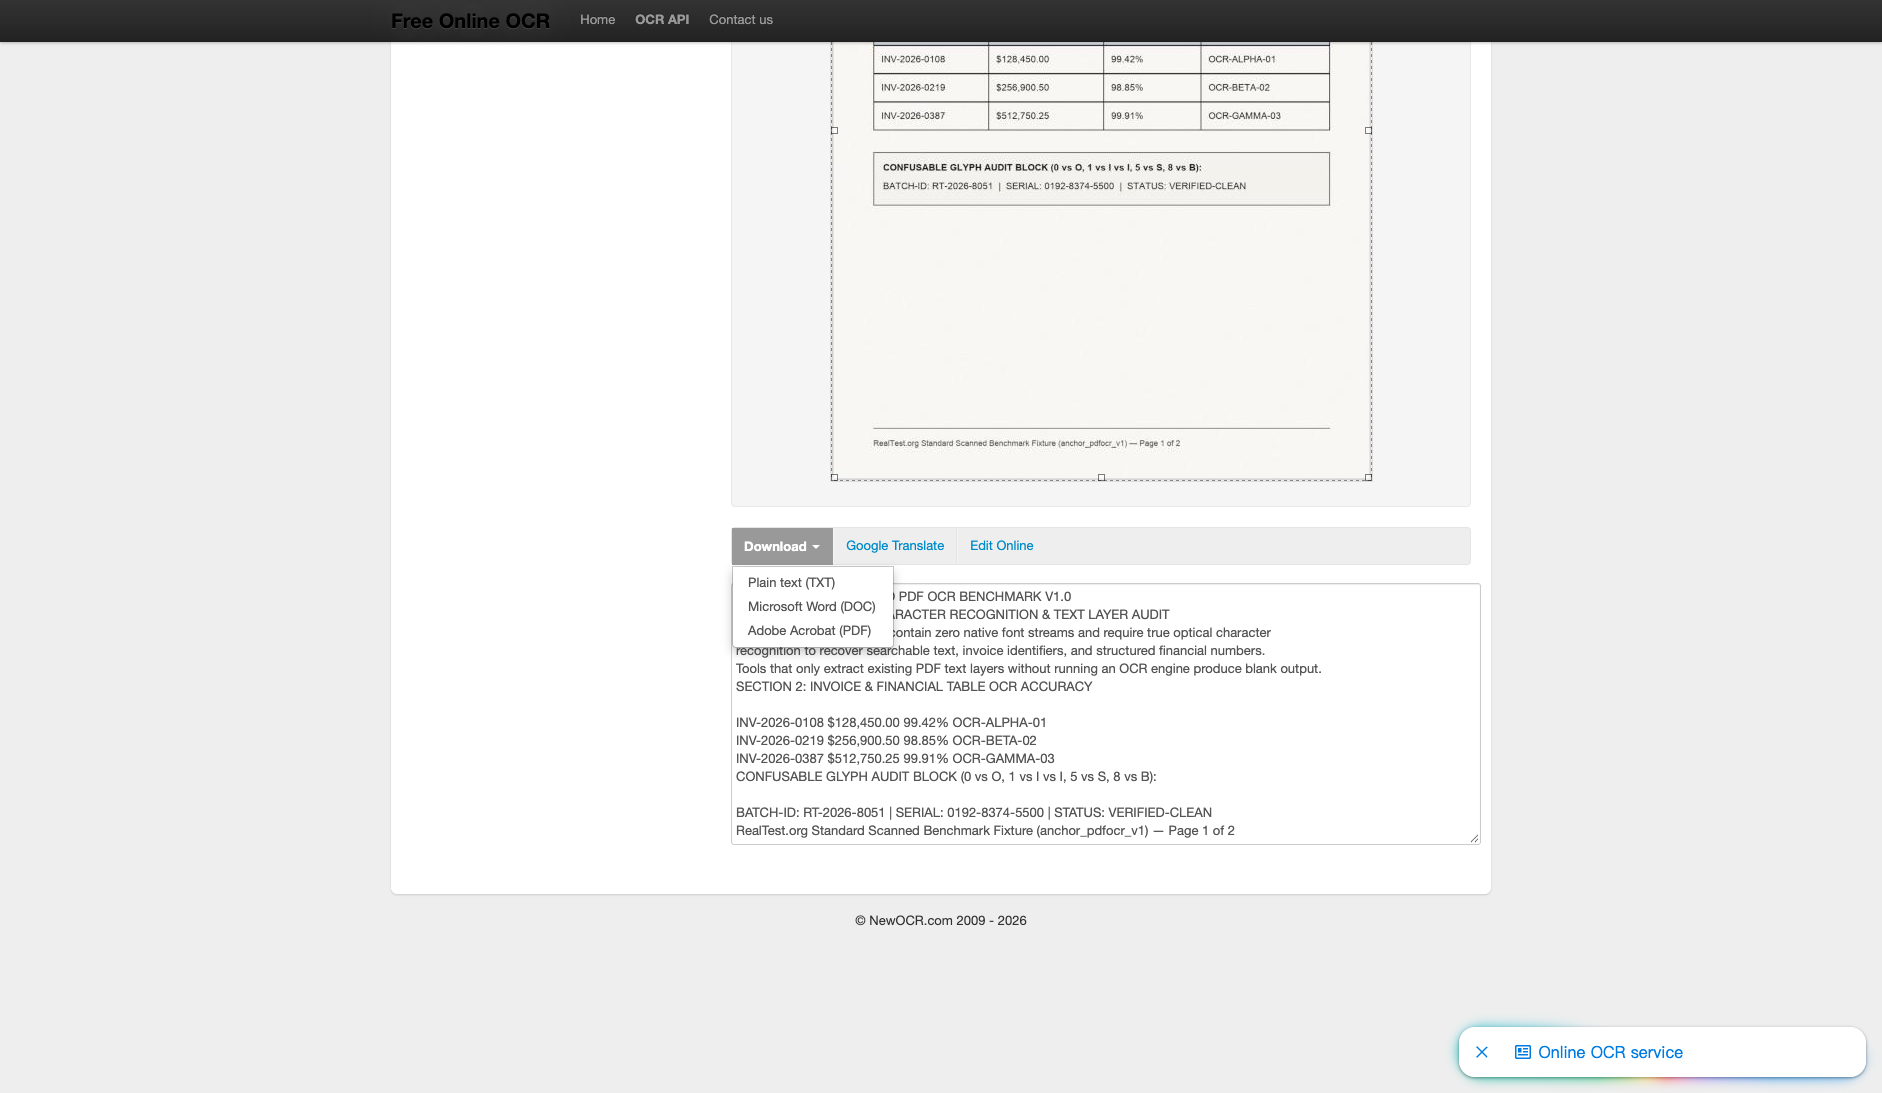
网页交互显示提取结果文本框,一键提供 TXT、DOC 与 PDF 导出文件,发票表格数据 100% 完整精确。
- 适用场景 · 历史评测建议
需要免注册免登录、即开即用快速从单页扫描文档中精准提取表格数字与文本内容的用户
- 效果与交付证据
交付能力
TXT · 有交付文件 · 实测无水印
详细事实与历史记录
- 交付规格记录
TXT · 有交付文件 · 实测无水印
- 历史规格描述 · 不代表官方上限
单页 UTF-8 纯文本 .txt (802 字节 · 表格准确率 100%)
- 水印记录
无水印
- 批量与 API
网页端支持单文件或 ZIP 压缩包上传;开发者提供 REST API 接口
- 免费档尺寸记录
未核验
- 所附文件实际尺寸
未核验
速度与稳定性
本次从操作到结果约 1.3 秒;稳定性未复测
详细事实与历史记录
- 计时记录
网络层服务端等待: 0.45s · 端到端参考: 1.3s
- 日期与测试素材
2026-11-02 · anchor_pdfocr_v1 · US-West (California, AS2914)
- 重复测试与稳定性
尚无统一的重复次数、成功率与波动区间记录。
交互体验
本次免登录
详细事实与历史记录
- 账号要求
本次流程无需登录
- 登录方式
免登录直接上传、预览与 OCR 识别导出
- 人工调整
未核验
- 交互与转化记录
免注册免登录使用,支持 122 种语言与排版分析。但页面搭载较多 Google AdSense 广告位,多页 PDF 默认单页预览与识别,需手动翻页。
背景与信誉
NewOCR.com · 长期信誉未独立核验
详细事实与历史记录
- 服务状态变化
未核验
- 运营主体
NewOCR.com
- 来源地区记录
美国 / 国际
- 域名历史记录
创立于 2011 年
- 背景与信誉评测观察
自 2011 年上线持续稳定运行逾 15 年,基于开源成熟 Tesseract OCR 引擎,在轻量免登录识别领域受众广泛。
- 外部信誉记录
自 2011 年持续运营逾十年,基于 Tesseract 开源技术构建,以无门槛全免费工具为特色。
工程与隐私
上传至云端处理;明确保留期限未确认;查看政策记录
详细事实与历史记录
- 处理位置
上传至云端处理
- 第三方追踪记录
Google AdSense · Google Analytics
- 工程与隐私评测观察
全站采用 HTTPS 加密传输,承诺识别完成后服务器即刻自动清理文件;但页面加载 Google AdSense 与 Analytics 第三方追踪脚本,且未提供一键即时销毁按钮。
- 数据留存声明
明确保留期限未确认;查看政策记录
本功能实测额度与收费披露
100% 免费无限制使用(含广告)
识别前后无隐藏付费弹窗,直接展示下载选项
整站套餐由产品节点统一维护(见顶部产品整站定价与规则底座 ↑)。
展开按「扫描件 PDF OCR 识别」容量对齐的整站方案表(2 条记录)
NewOCR 网页免登录完全免费模式与开发者 REST API 点数 · 2026-11-02
基于 Tesseract OCR 引擎提取文本,支持 122 种语言、数学公式与版面分析,导出 TXT/DOC/PDF;网页端包含展示广告,处理速度取决于公共服务器排队情况
通过标准 REST API 接口自动化批量上传与提取文本,返回结构化 JSON;面向开发者的程序化接口,需申请 API key
2 条方案/周期记录,全部列出;— 表示未记录该周期。
网页端 OCR 工具免登录完全免费且不限文件上传数量,含广告展示;开发者 API 提供 20 页免费测试,超出后按 $0.005/页 计费(每 1,000 次识别 $5.00)。
评价依据与完整评分 · 综合 78.1/100
综合分 = 诚信与口碑 × 30% + 功能实力 × 70%。分项满分沿用本报告量表。列表整数仅为四舍五入展示,此处保留原始精度。
方法版本 2.3.1 · 测试素材 anchor_pdfocr_v1
诚信与口碑 · 79/100 · 30%
| 维度 | 得分 | 理由 | 依据 |
|---|---|---|---|
| 定价与规则透明度 | 33 / 35 | 网页端 100% 免费开放且不限文件上传数量,无隐藏收费;开发者 API 提供 20 页免费测试,超出后按 $0.005/页计费,明码标价。 | 证据 A → |
| 交互与转化克制 | 20 / 30 | 免注册免登录使用,支持 122 种语言与排版分析。但页面搭载较多 Google AdSense 广告位,多页 PDF 默认单页预览与识别,需手动翻页。 | 证据 A → |
| 背景与外部信誉 | 16 / 20 | 自 2011 年上线持续稳定运行逾 15 年,基于开源成熟 Tesseract OCR 引擎,在轻量免登录识别领域受众广泛。 | 证据 A → |
| 基础工程与隐私 | 10 / 15 | 全站采用 HTTPS 加密传输,承诺识别完成后服务器即刻自动清理文件;但页面加载 Google AdSense 与 Analytics 第三方追踪脚本,且未提供一键即时销毁按钮。 | 证据 A → |
功能实力 · 77.7/100 · 70%
| 维度 | 得分 | 理由 | 依据 |
|---|---|---|---|
| 任务质量 | 49.2 / 65 | OCR 导出文本与表格确定性检验:免登录导出 802 字节纯文本 TXT 交付物,第一页易混淆财务表格单元格命中 12/12(表格准确率 100%),标题命中 3/4;因网页工具默认按页交互处理,未自动合并第 2 页内容 (49.2/65) | 证据 A → |
| 交付规格 | 14 / 20 | 免登录直接提供 TXT、DOC、PDF 格式下载,交付物为选中页纯文本提取内容(802 字节),未合成双页带文字层 PDF (14/20) | 证据 A → |
| 处理速度 | 14.5 / 15 | 云端 Tesseract OCR 服务端处理耗时仅 0.45s,端到端耗时 1.30s (14.5/15) | 证据 A → |
历史评分可能包含官方最高能力声明;本次实测结果与付费能力分别阅读。缺少统一档位和范围时,不作统一排名。
开发者与引用工具箱 · 认领更新、新增测评与嵌入实测徽章(Markdown / HTML)
欢迎产品开发者在官网、GitHub README 或介绍页嵌入以下 SVG 徽章(直接链接至本产品的公开实测档案),或通过下方通道同步最新整站套餐与新功能。

[](https://realtest.org/zh/tools/newocr.com/) <a href="https://realtest.org/zh/tools/newocr.com/"><img src="https://realtest.org/badges/newocr.com.svg" alt="NewOCR — RealTest" height="24" /></a> 
[](https://realtest.org/zh/tools/newocr.com/#feature-pdf-ocr)