NewOCR · 扫描件 PDF OCR 识别
NewOCR(创立于 2011 年)是一款广受全球用户喜爱的轻量级纯免费在线光学字符识别(OCR)服务平台。免登录即可上传扫描件并提取可编辑文本,支持多语言与排版解析,提供 TXT/DOC/PDF 格式导出。
US-West (California, AS2914)
TXT · 有交付文件 · 查看原生文件 ↗
后续价格与服务状态核验独立展示,不改写历史实测评分。
单次结果不泛化为全部复杂场景、未测付费最高规格或长期在线率。
定价方案与历史记录
NewOCR 网页免登录完全免费模式与开发者 REST API 点数 · 2026-11-02
基于 Tesseract OCR 引擎提取文本,支持 122 种语言、数学公式与版面分析,导出 TXT/DOC/PDF;网页端包含展示广告,处理速度取决于公共服务器排队情况
通过标准 REST API 接口自动化批量上传与提取文本,返回结构化 JSON;面向开发者的程序化接口,需申请 API key
2 条方案/周期记录,全部列出;— 表示未记录该周期。
网页端 OCR 工具免登录完全免费且不限文件上传数量,含广告展示;开发者 API 提供 20 页免费测试,超出后按 $0.005/页 计费(每 1,000 次识别 $5.00)。
测试当日的价格记录 · 2026-11-02
100% 免费网页工具(广告赞助) / 开发者 REST API 每千次 $5.00
100% 免费网页工具(广告赞助) / 开发者 REST API 每千次 $5.00
仅保留历史上下文,不适用于当前购买。
交付能力与使用门槛
- 免费交付记录
- 单页 UTF-8 纯文本 .txt (802 字节 · 表格准确率 100%)
- 水印
- 无水印
- 免费额度
- 100% 免费无限制使用(含广告)
- 登录要求
- 免登录直接上传、预览与 OCR 识别导出
- 最高规格记录
- 单页 UTF-8 纯文本 .txt (802 字节 · 表格准确率 100%)
可能包含官方声明;不能推定该档位已实测。
- 批量与 API
- 网页端支持单文件或 ZIP 压缩包上传;开发者提供 REST API 接口
- 手动调整
- 未记录或未核验
本次实测与效果样本
网页交互显示提取结果文本框,一键提供 TXT、DOC 与 PDF 导出文件,发票表格数据 100% 完整精确。
- 素材
- anchor_pdfocr_v1
- 测试环境记录
- US-West (California, AS2914)
- 网络层服务端等待
- 0.45 s
- 端到端参考
- 1.3 s
网络等待包含往返、排队和轮询误差,不是纯推理时间。本地耗时受设备影响;历史记录未统一重复次数。
使用体验、规则与可信度
- 限制披露
- 识别前后无隐藏付费弹窗,直接展示下载选项
- 交互观察
- 免注册免登录使用,支持 122 种语言与排版分析。但页面搭载较多 Google AdSense 广告位,多页 PDF 默认单页预览与识别,需手动翻页。
- 主体记录
- NewOCR.com
- 来源地区
- 美国 / 国际
- 域名历史记录
- 创立于 2011 年
- 第三方追踪记录
- Google AdSense · Google Analytics
- 外部资料摘要
- 自 2011 年持续运营逾十年,基于 Tesseract 开源技术构建,以无门槛全免费工具为特色。
- 处理方式
- 云端 Tesseract OCR 引擎 (cloud_tesseract_ocr)
- 留存声明
- 上传图片及处理产物在 OCR 处理完成后立即从服务器端自动清理删除,不进行长期数据留存。
记录声明内容,不表示已经验证实际删除或所有数据处理行为。
可核查证据链与截图记录
以下四个环节将标准输入样本、同轮界面截图、原生导出产物与官方定价快照串联,均经 SHA-256 字节校验。
anchor_pdfocr_v1 · 查看原始测试素材与检查器 →
记录着陆入口、结果界面与导出限制披露。
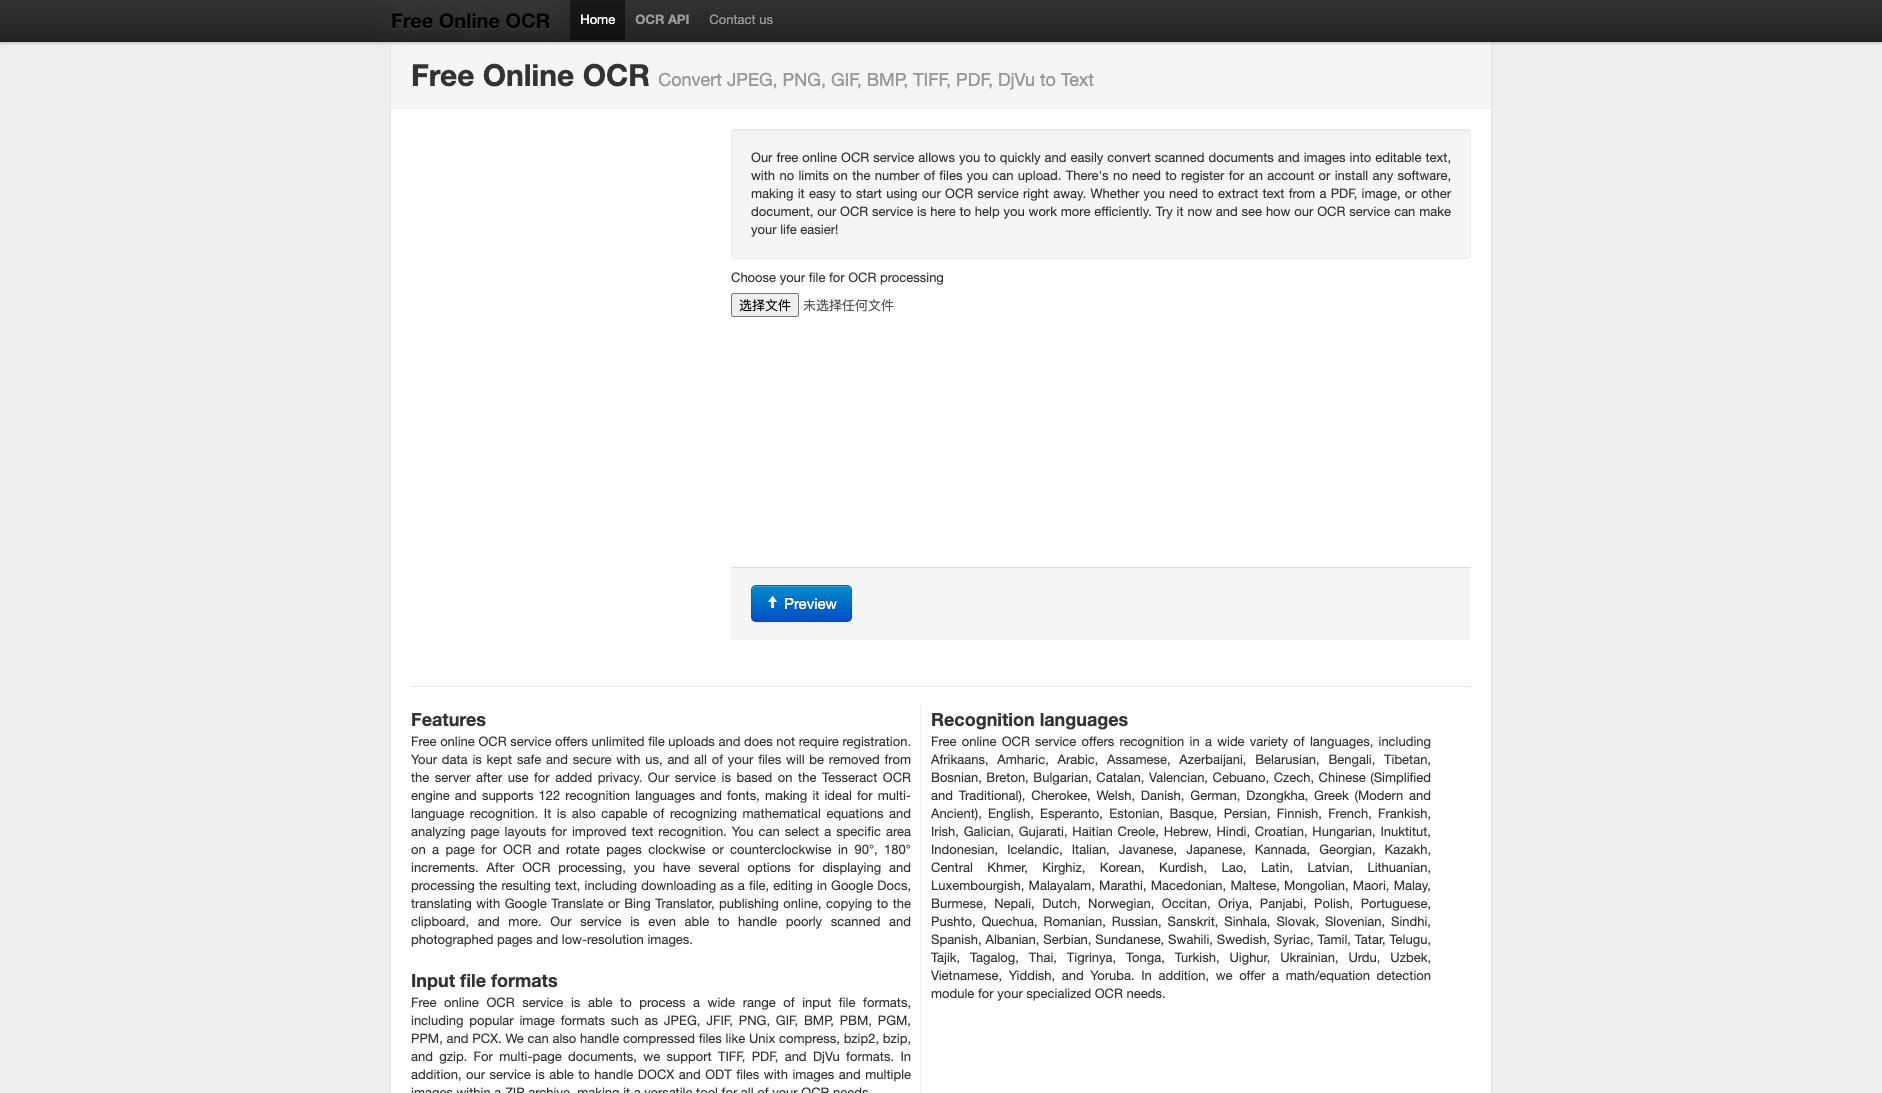
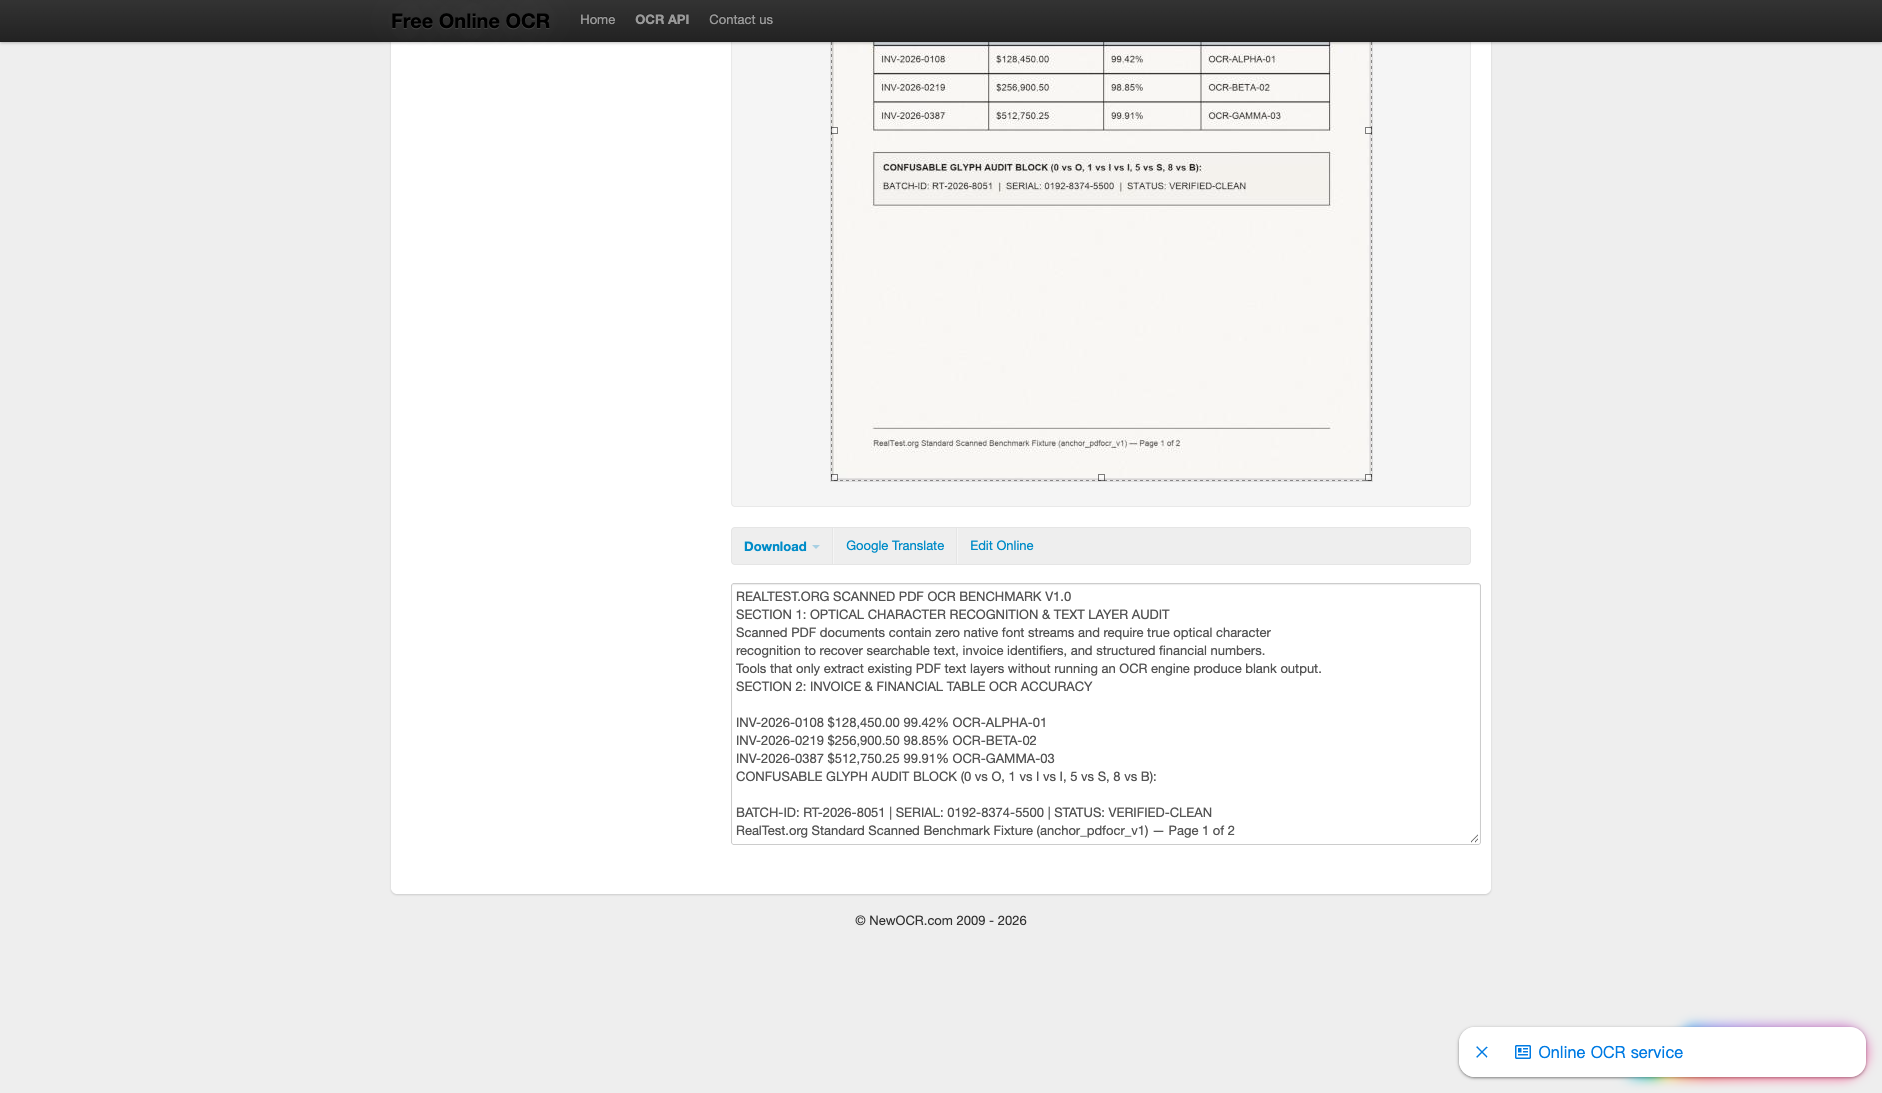
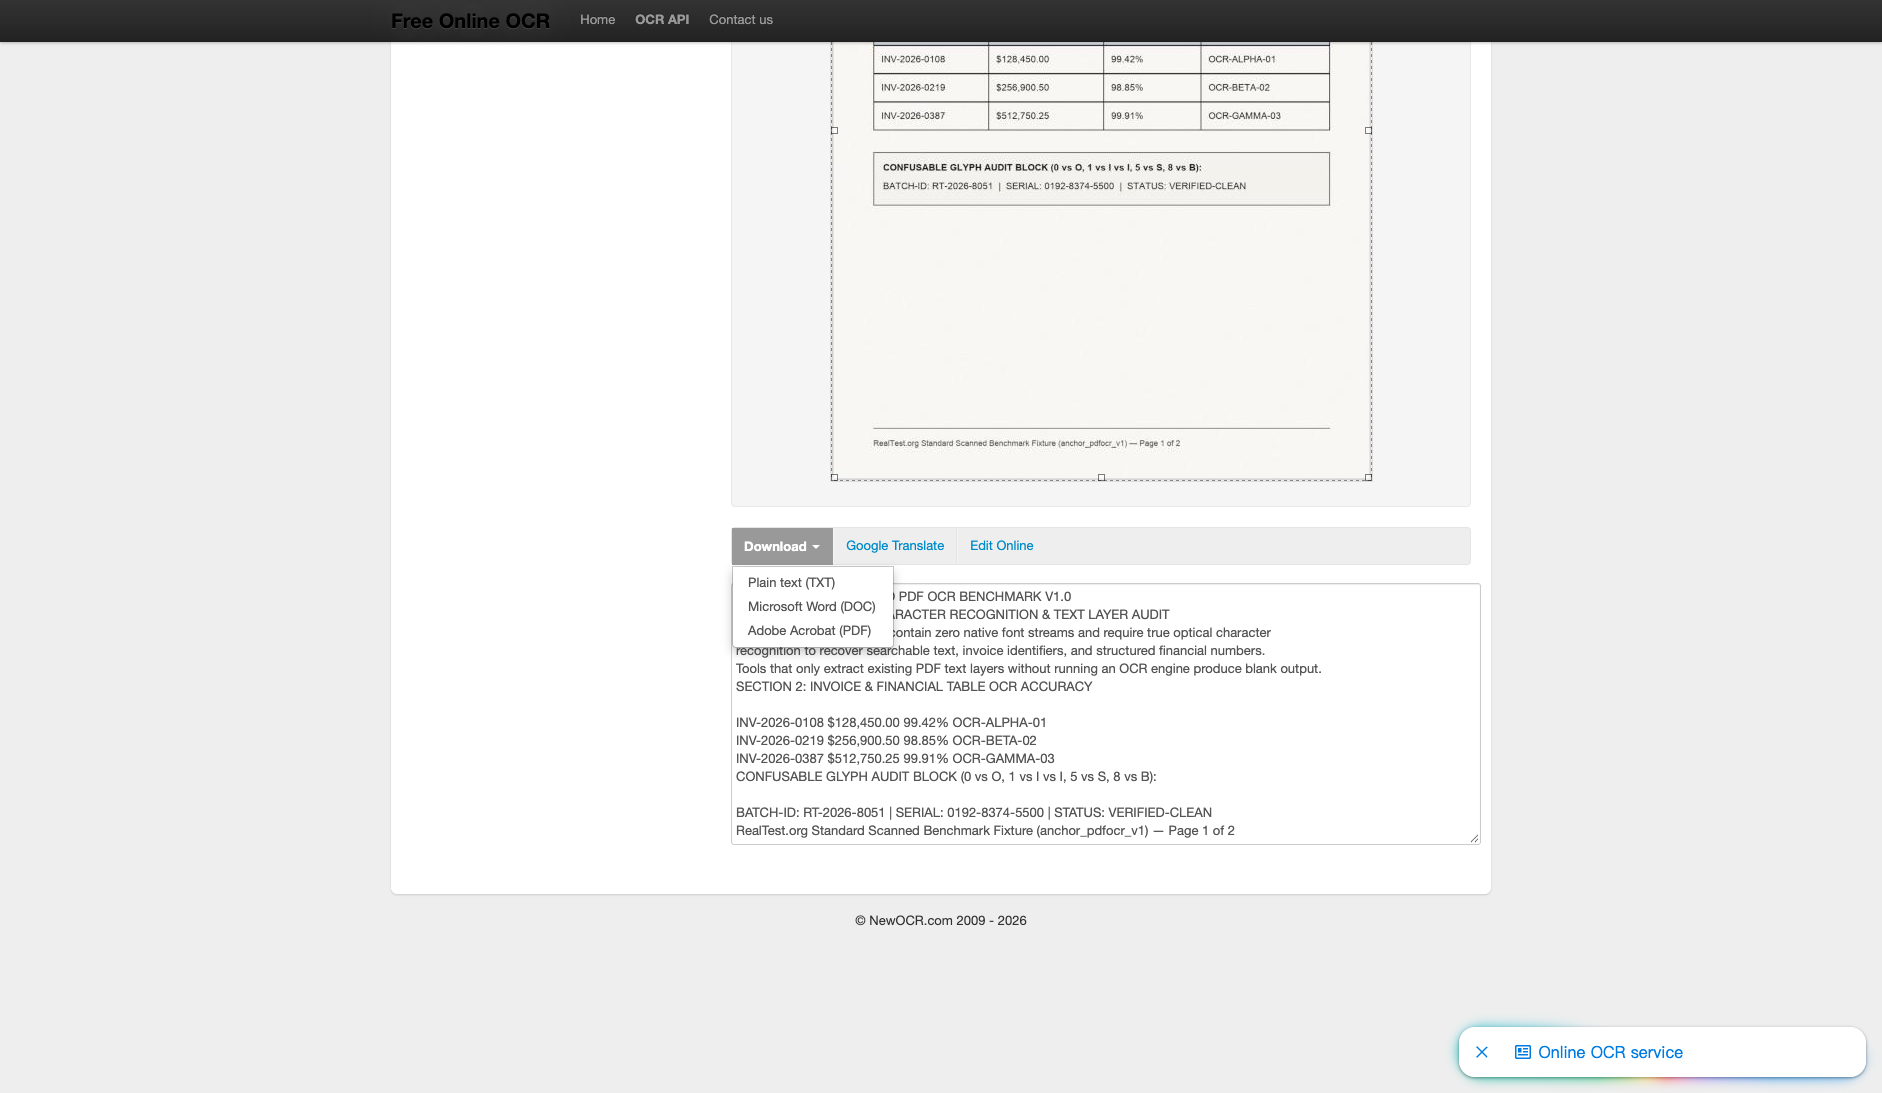
页面截图、原生输出和官方声明分别支持不同结论。证据等级不代表整个产品获得安全认证。
评价依据与完整评分 · 综合 78.1/100
综合分 = 诚信与口碑 × 30% + 功能实力 × 70%。分项满分沿用本报告量表。列表整数仅为四舍五入展示,此处保留原始精度。
方法版本 2.3.1 · 测试素材 anchor_pdfocr_v1
诚信与口碑 · 79/100 · 30%
| 维度 | 得分 | 理由 | 依据 |
|---|---|---|---|
| 定价与规则透明度 | 33 / 35 | 网页端 100% 免费开放且不限文件上传数量,无隐藏收费;开发者 API 提供 20 页免费测试,超出后按 $0.005/页计费,明码标价。 | 证据 A → |
| 交互与转化克制 | 20 / 30 | 免注册免登录使用,支持 122 种语言与排版分析。但页面搭载较多 Google AdSense 广告位,多页 PDF 默认单页预览与识别,需手动翻页。 | 证据 A → |
| 背景与外部信誉 | 16 / 20 | 自 2011 年上线持续稳定运行逾 15 年,基于开源成熟 Tesseract OCR 引擎,在轻量免登录识别领域受众广泛。 | 证据 A → |
| 基础工程与隐私 | 10 / 15 | 全站采用 HTTPS 加密传输,承诺识别完成后服务器即刻自动清理文件;但页面加载 Google AdSense 与 Analytics 第三方追踪脚本,且未提供一键即时销毁按钮。 | 证据 A → |
功能实力 · 77.7/100 · 70%
| 维度 | 得分 | 理由 | 依据 |
|---|---|---|---|
| 任务质量 | 49.2 / 65 | OCR 导出文本与表格确定性检验:免登录导出 802 字节纯文本 TXT 交付物,第一页易混淆财务表格单元格命中 12/12(表格准确率 100%),标题命中 3/4;因网页工具默认按页交互处理,未自动合并第 2 页内容 (49.2/65) | 证据 A → |
| 交付规格 | 14 / 20 | 免登录直接提供 TXT、DOC、PDF 格式下载,交付物为选中页纯文本提取内容(802 字节),未合成双页带文字层 PDF (14/20) | 证据 A → |
| 处理速度 | 14.5 / 15 | 云端 Tesseract OCR 服务端处理耗时仅 0.45s,端到端耗时 1.30s (14.5/15) | 证据 A → |
历史评分可能包含官方最高能力声明;本次实测结果与付费能力分别阅读。缺少统一档位和范围时,不作统一排名。
修订与更正
- 2026-11-02
完成 anchor_pdfocr_v1 纯位图扫描件 PDF OCR 文本提取、表格易混淆数字还原与服务端时序真机实测